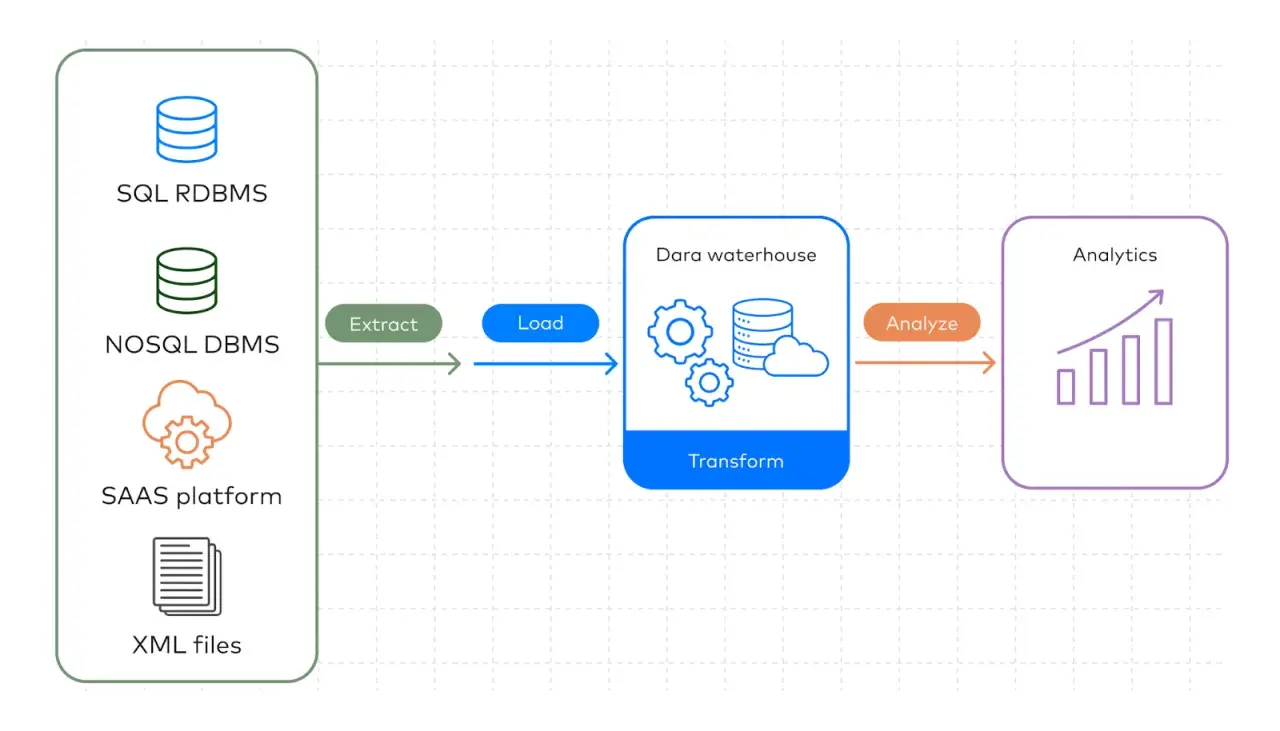
Wenn Daten aus Shopsystemen, Sensoren, Kundendatenbanken oder Webanwendungen zusammenlaufen, entsteht schnell ein unübersichtlicher Mix aus Formaten, Zeitstempeln und Qualitätsproblemen. Eine Data Pipeline sorgt dafür, dass diese Informationen automatisiert erfasst, verarbeitet und am richtigen Ziel bereitgestellt werden. Ich zeige, wie der Ablauf funktioniert, welche Varianten es gibt und worauf es bei Datenanalyse und Datenbanken in der Praxis ankommt.
Eine Data Pipeline bringt Rohdaten zuverlässig zur Analyse
- Automatischer Datenfluss: Daten werden aus mehreren Quellen abgerufen, geprüft, verändert und gespeichert.
- Typischer Ablauf: Die Pipeline besteht aus Erfassung, Transformation, Qualitätssicherung, Speicherung und Überwachung.
- ETL und ELT: Der wichtigste Unterschied liegt darin, ob die Daten vor oder erst nach dem Laden transformiert werden.
- Batch oder Echtzeit: Zeitgesteuerte Verarbeitung reicht für viele Berichte aus, Streaming wird bei aktuellen Ereignissen benötigt.
- Qualität entscheidet: Monitoring, Wiederholungen und nachvollziehbare Datenherkunft sind genauso wichtig wie Geschwindigkeit.
Was eine Data Pipeline konkret leistet
Eine Data Pipeline ist eine technische Verarbeitungskette, durch die Daten von einer oder mehreren Quellen zu einem Zielsystem gelangen. Zwischen diesen Punkten können die Daten gefiltert, vereinheitlicht, angereichert und validiert werden. Das Ziel ist meist ein Data Warehouse, ein Data Lake, eine operative Datenbank oder ein Analysewerkzeug.
Ein einfaches Beispiel macht das Prinzip greifbar. Ein Onlinehändler übernimmt Bestellungen aus seinem Shopsystem, ergänzt Kundendaten aus dem CRM und aktualisiert anschließend ein Dashboard mit Umsatz, Retouren und Lagerbestand. Ohne automatisierte Pipeline müsste jemand diese Informationen regelmäßig exportieren, zusammenführen und auf Fehler prüfen.
Ich betrachte eine Pipeline deshalb nicht nur als Verbindung zwischen zwei Datenbanken. Sie ist eher ein verlässlicher Prozess mit klaren Regeln. Dazu gehören auch Zeitpläne, Fehlerbehandlung, Zugriffsrechte, Protokolle und die Frage, wie sich eine fehlerhafte Lieferung später nachvollziehen lässt.
Aus welchen Bausteinen der Datenfluss besteht
Die meisten Pipelines folgen einem ähnlichen Muster, auch wenn die eingesetzten Technologien sehr unterschiedlich sein können. Entscheidend ist weniger der Produktname als die saubere Trennung der einzelnen Aufgaben.
Datenquellen und Erfassung
Am Anfang stehen Quellen wie relationale Datenbanken, CSV-Dateien, Programmierschnittstellen, Geschäftsanwendungen, Maschinen oder Webserver. Die Erfassung, auch Ingestion genannt, kopiert oder empfängt die Daten und legt fest, ob dies einmalig, regelmäßig oder fortlaufend geschieht.
Bei einer täglichen Umsatzanalyse genügt oft ein nächtlicher Import. Bei Betrugserkennung, Maschinenüberwachung oder Logdaten kann dagegen eine Verzögerung von wenigen Minuten bereits zu lang sein. Die gewünschte Aktualität bestimmt daher früh, welche Architektur sinnvoll ist.
Transformation und Anreicherung
Rohdaten sind selten direkt analysierbar. In diesem Schritt werden Datumsformate vereinheitlicht, doppelte Datensätze entfernt, fehlende Werte behandelt und Tabellen miteinander verbunden. Eine Transformation kann außerdem aus Einzelwerten neue Kennzahlen bilden, etwa den Bestellwert pro Kunde oder die durchschnittliche Lieferzeit.
Besonders wichtig ist die fachliche Logik. Wenn ein Unternehmen eine Stornierung anders behandelt als eine Retoure, muss diese Regel im Prozess eindeutig dokumentiert sein. Technisch korrekte Daten können fachlich trotzdem falsch interpretiert werden, wenn solche Definitionen fehlen.
Speicherung und Bereitstellung
Nach der Verarbeitung landen die Daten beispielsweise in einem Data Warehouse für strukturierte Berichte oder in einem Data Lake für große Mengen unterschiedlicher Formate. Für operative Anwendungen kann auch eine klassische relationale Datenbank das richtige Ziel sein.
Die Speicherung sollte zum Verwendungszweck passen. Ein Dashboard braucht schnelle, vorbereitete Abfragen. Ein Data-Science-Team benötigt möglicherweise detaillierte Rohdaten, die später mit unterschiedlichen Verfahren untersucht werden können. Eine einzige Ablage löst nicht automatisch alle Analyseprobleme.
Lesen Sie auch: Visual Studio SQL - Datenbankprojekte meistern & Fehler vermeiden
Orchestrierung und Überwachung
Die Orchestrierung steuert, in welcher Reihenfolge einzelne Aufgaben laufen und welche Schritte voneinander abhängen. Sie kann einen Prozess nach erfolgreicher Datenübernahme starten, fehlerhafte Aufgaben wiederholen und Verantwortliche benachrichtigen.
In der Praxis macht gerade dieser Teil den Unterschied zwischen einem Skript und einer belastbaren Pipeline. Ich würde keine wichtige Datenstrecke ohne Protokollierung, Fehlermeldungen und sichtbaren Status betreiben. Wenn ein Bericht plötzlich falsche Werte zeigt, muss erkennbar sein, ob die Quelle leer war, eine Transformation fehlgeschlagen ist oder die Daten verspätet ankamen.
ETL und ELT unterscheiden sich an einer entscheidenden Stelle
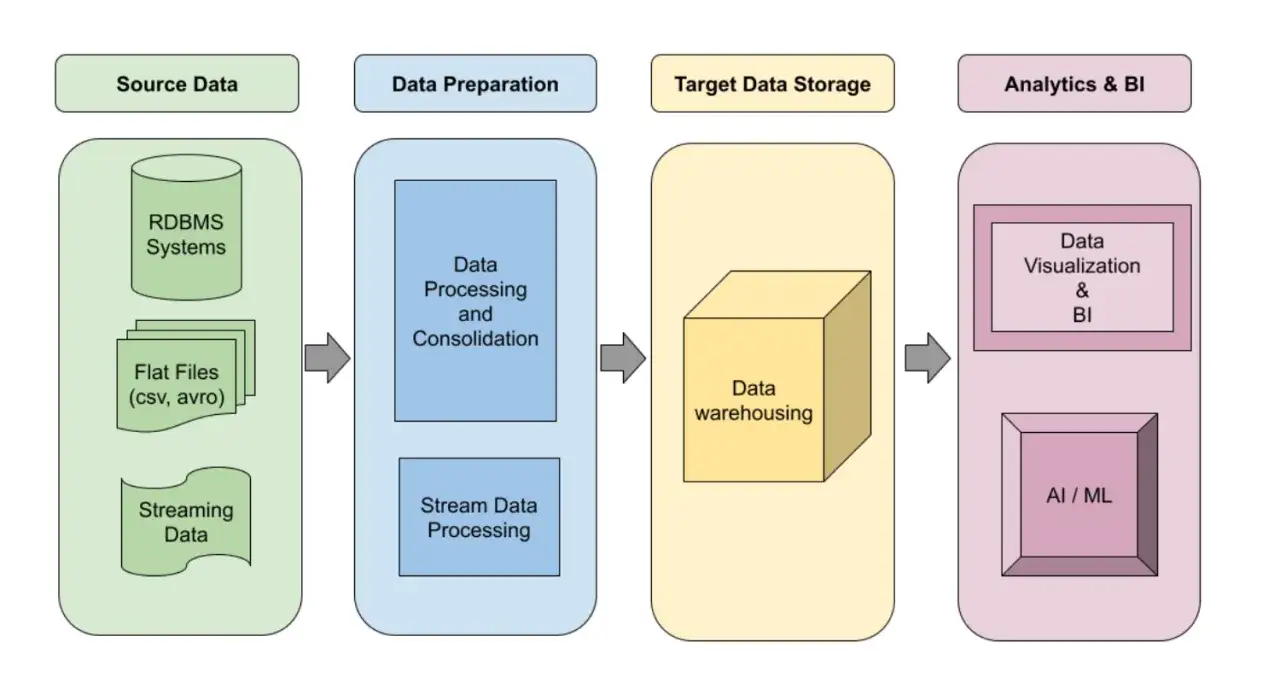
Die Begriffe ETL und ELT beschreiben zwei verbreitete Vorgehensweisen. Bei ETL werden Daten extrahiert, transformiert und erst danach in das Zielsystem geladen. Bei ELT werden sie zunächst geladen und anschließend innerhalb des Zielsystems verarbeitet.
| Merkmal | ETL | ELT |
|---|---|---|
| Reihenfolge | Transformieren vor dem Laden | Laden vor dem Transformieren |
| Typischer Einsatz | Streng kontrollierte Zielsysteme und ältere Architekturen | Cloud Data Warehouses und große Analyseumgebungen |
| Stärke | Das Ziel erhält bereits bereinigte Daten | Rohdaten bleiben flexibel verfügbar |
| Schwäche | Änderungen an der Logik können aufwendig sein | Das Zielsystem braucht ausreichend Rechenleistung und Kontrolle |
ELT ist nicht grundsätzlich moderner oder automatisch besser. Es passt gut, wenn ein leistungsfähiges Zielsystem vorhanden ist und Rohdaten für spätere Analysen erhalten bleiben sollen. ETL kann sinnvoller sein, wenn sensible Informationen vor der Ablage maskiert werden müssen oder das Zielsystem nur fertig aufbereitete Daten akzeptiert.
Entscheidend ist auch die Frage nach der Wiederholbarkeit. Eine gute Pipeline kann denselben Zeitraum erneut verarbeiten, ohne Datensätze doppelt einzufügen. Dafür werden beispielsweise eindeutige Schlüssel, Ladezeitpunkte oder sogenannte idempotente Verarbeitungsschritte verwendet. Sie liefern bei wiederholter Ausführung dasselbe Ergebnis, sofern sich die Eingabedaten nicht geändert haben.
Batch oder Echtzeit entscheidet über die Geschwindigkeit
Bei der Batch-Verarbeitung werden Daten gesammelt und in festen Intervallen verarbeitet. Ein täglicher Import von Rechnungen oder ein stündlicher Abgleich von Lagerbeständen ist dafür typisch. Diese Variante ist oft einfacher, günstiger und leichter zu testen als ein kontinuierlicher Datenstrom.
Streaming-Pipelines verarbeiten Ereignisse nahezu fortlaufend. Das passt zu Anwendungsfällen wie Live-Monitoring, Telemetrie, personalisierten Empfehlungen oder der Erkennung verdächtiger Zahlungsvorgänge. Dafür müssen Systeme mit verspäteten, doppelten oder falsch sortierten Ereignissen umgehen können.
| Variante | Geeignet für | Worauf es ankommt |
|---|---|---|
| Batch | Monatsberichte, Abrechnungen, regelmäßige Datenimporte | Planung, vollständige Läufe und klare Zeitfenster |
| Micro-Batch | Aktualisierungen alle paar Minuten | Kompromiss zwischen Aktualität und überschaubarer Komplexität |
| Streaming | Live-Dashboards, Sensoren, Betrugserkennung | Geringe Latenz, Ereignisreihenfolge und robuste Fehlerbehandlung |
Viele Teams überschätzen den Nutzen von Echtzeit. Wenn ein Managementbericht nur morgens betrachtet wird, bringt eine Verarbeitung im Sekundenbereich kaum einen Vorteil. Ich würde zuerst die benötigte Aktualität messen und erst dann die technische Komplexität erhöhen.
Wo Data Pipelines in der Praxis eingesetzt werden
Im E-Commerce führen Pipelines Bestellungen, Zahlungen, Retouren und Lagerdaten zusammen. Aus diesen Informationen entstehen Kennzahlen wie Conversion-Rate, Warenkorbwert oder Lieferfähigkeit. Der praktische Nutzen liegt darin, dass dieselben Regeln für alle Berichte gelten und nicht jeder Analyst seine eigene Version der Umsatzlogik baut.
In der Produktion sammeln Pipelines Maschinendaten, Temperaturwerte und Wartungsprotokolle. Werden Grenzwerte überschritten, kann ein Warnsystem reagieren. Für vorausschauende Wartung reicht es jedoch nicht, Messwerte nur zu speichern. Die Pipeline muss sie mit Maschinenstammdaten, Zeitfenstern und Wartungshistorien verbinden.
Auch Marketing- und Finanzsysteme profitieren davon. Kampagnendaten lassen sich mit Vertrags- oder Kundendaten kombinieren, während Finanzabteilungen Zahlungsbewegungen aus mehreren Systemen in einer konsistenten Datenbasis auswerten können. Der größte Mehrwert entsteht durch Zusammenführung, nicht durch das bloße Verschieben einzelner Dateien.
Bei personenbezogenen Daten gelten zusätzlich Datenschutz und Zugriffskontrolle. Nicht jede Information gehört in jedes Zielsystem. Eine sinnvolle Pipeline entfernt unnötige Felder, pseudonymisiert Daten, begrenzt Zugriffe und dokumentiert, woher ein Wert stammt und wie er verändert wurde.
Was eine Pipeline zuverlässig und wartbar macht
Die häufigsten Probleme entstehen nicht durch fehlende Rechenleistung, sondern durch unklare Datenverträge. Ein Datenvertrag beschreibt zum Beispiel, welche Spalten vorhanden sind, welche Datentypen gelten und wie fehlende Werte behandelt werden. Ändert eine Quelle plötzlich den Namen eines Feldes, sollte die Pipeline das erkennen und nicht stillschweigend falsche Ergebnisse produzieren.
Ich achte bei produktiven Pipelines besonders auf vier Kontrollpunkte:
- Validierung: Stimmen Datentypen, Mengen und Wertebereiche mit den Erwartungen überein?
- Fehlerbehandlung: Werden fehlerhafte Datensätze isoliert oder bricht gleich der gesamte Lauf ab?
- Wiederanlauf: Kann ein fehlgeschlagener Schritt sicher wiederholt werden?
- Beobachtbarkeit: Sind Laufzeit, Datenvolumen und Fehlerquote sichtbar?
Ein weiterer Punkt ist die Datenherkunft, oft Data Lineage genannt. Sie zeigt, aus welcher Quelle ein Wert stammt, welche Transformationen ihn verändert haben und in welchem Bericht er verwendet wird. Das hilft bei Audits, Fehlersuche und fachlichen Rückfragen erheblich.
Auch Tests gehören in den Entwicklungsprozess. Neben normalen Softwaretests sind Prüfungen auf Datenqualität nötig, etwa Mindestmengen, erlaubte Kategorien oder ungewöhnliche Sprünge. Eine Pipeline kann technisch erfolgreich beendet sein und trotzdem einen falschen Bericht erzeugen, wenn nur der Programmstatus und nicht das Ergebnis kontrolliert wird.
Wie man die passende Architektur auswählt
Für eine kleine Datenmenge reicht möglicherweise ein zeitgesteuertes Skript, das eine Datei einliest und in eine Datenbank schreibt. Sobald mehrere Quellen, Abhängigkeiten oder Nutzergruppen hinzukommen, braucht es meist eine stärker strukturierte Lösung mit zentraler Überwachung und versionierten Transformationen.
Vor der Auswahl eines Werkzeugs kläre ich deshalb zuerst fünf Fragen:
- Wie viele Daten entstehen pro Stunde, Tag oder Monat?
- Wie schnell müssen neue Daten verfügbar sein?
- Wie häufig ändern sich Struktur und Geschäftsregeln?
- Welche Datenschutz- und Aufbewahrungsregeln gelten?
- Wer überwacht die Pipeline und reagiert bei Fehlern?
Erst danach lohnt sich der Vergleich konkreter Plattformen. Eine komplexe Cloud-Architektur kann bei wenigen Megabyte pro Tag unnötig teuer und schwer wartbar sein. Umgekehrt stößt eine Sammlung lokaler Skripte schnell an Grenzen, wenn Daten kontinuierlich eintreffen und mehrere Teams darauf angewiesen sind.
Für einen belastbaren Start genügt oft ein kleiner, sauber dokumentierter Prozess. Ich würde mit einer Quelle, einem klaren Ziel und wenigen überprüfbaren Kennzahlen beginnen. Danach lassen sich weitere Quellen hinzufügen, ohne die gesamte Architektur auf einmal zu überladen.
Eine gute Pipeline endet nicht beim erfolgreichen Datenimport
Eine Data Pipeline ist dann wertvoll, wenn sie nicht nur Daten bewegt, sondern verlässliche Entscheidungen ermöglicht. Dazu braucht es klare Definitionen, passende Verarbeitungsgeschwindigkeit, kontrollierte Zugriffe und eine Überwachung, die Probleme sichtbar macht.
Wer den Prozess plant, sollte deshalb nicht zuerst nach dem bekanntesten Werkzeug greifen. Die bessere Reihenfolge ist, Datenquellen, Aktualitätsbedarf, Qualitätsregeln und Verantwortlichkeiten zu klären. Erst daraus ergibt sich, ob eine einfache Batch-Lösung, ein ELT-Prozess im Data Warehouse oder eine Streaming-Architektur wirklich sinnvoll ist.
Mein wichtigster Praxisrat lautet: Eine kleinere Pipeline mit nachvollziehbaren Regeln ist meist mehr wert als eine beeindruckende Plattform, deren Ergebnisse niemand zuverlässig erklären kann.